Monitoring scheitert selten an der Technik. Es scheitert daran, dass niemand hinsieht, oder dass die Benachrichtigung genau dann nicht ankommt, wenn sie sollte.
Schicht 1: Erreichbarkeit, Uptime Kuma#
Der schnellste sinnvolle Einstieg. Prüft von außen, ob ein Dienst antwortet, und meldet sich, wenn nicht.
services:
  kuma:
    image: louislam/uptime-kuma:1.23-alpine
    restart: unless-stopped
    ports:
      - "127.0.0.1:3001:3001"
    volumes:
      - kuma-daten:/app/data
volumes:
  kuma-daten:
Hinter einen Reverse-Proxy hängen, dann ist es über einen Namen erreichbar.
Was tatsächlich überwacht gehört, die Liste ist kürzer, als man denkt, aber jeder Punkt sollte eine Handlung auslösen:
| Prüfung | Typ | Intervall |
|---|---|---|
| Webseite antwortet mit 200 | HTTP(s) | 60 s |
| Zertifikat läuft in < 14 Tagen ab | HTTP(s), Kuma warnt automatisch | 60 s |
| Datenbank erreichbar | TCP-Port | 60 s |
| DNS liefert die erwartete Adresse | DNS | 300 s |
| Nächtliches Backup gelaufen | Push (siehe unten) | 25 h |
Ein Kuma, das auf demselben Server läuft wie die überwachten Dienste, meldet den Ausfall dieses Servers nicht, es ist dann selbst weg. Die Erreichbarkeitsprüfung gehört auf eine andere Maschine, idealerweise bei einem anderen Anbieter. Ein kleiner VPS für ein paar Euro reicht dafür völlig.
Schicht 2: Trends, Prometheus und Exporter#
Erreichbarkeit sagt, ob etwas kaputt ist. Trends sagen, dass es kaputt gehen wird: eine Platte, die seit Wochen um 2 % pro Tag volläuft, ein RAM-Verbrauch, der nach jedem Deploy nicht mehr zurückgeht.
services:
  prometheus:
    image: prom/prometheus:v3.6.0
    restart: unless-stopped
    ports: ["127.0.0.1:9090:9090"]
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prom-daten:/prometheus
    command:
      - '--config.file=/etc/prometheus/prometheus.yml'
      - '--storage.tsdb.retention.time=90d'

  node-exporter:
    image: prom/node-exporter:v1.9.1
    restart: unless-stopped
    pid: host
    network_mode: host
    volumes: [ "/:/host:ro,rslave" ]
    command: [ '--path.rootfs=/host' ]

volumes:
  prom-daten:
# prometheus.yml
global:
scrape_interval: 30s
scrape_configs:
- job_name: node
static_configs:
- targets: ['host.docker.internal:9100']
labels: { host: web01 }
# Proxmox-Hosts liefern über den pve-exporter Werte pro Gast
- job_name: pve
static_configs:
- targets: ['10.99.0.1:9221']
metrics_path: /pve
params:
module: [default]Die vier Abfragen, die man tatsächlich braucht, der Rest ist Zierde:
# Platte: in wie vielen Stunden ist sie voll? (lineare Fortschreibung)
predict_linear(node_filesystem_avail_bytes{mountpoint="/"}[6h], 3600*24) < 0

# RAM wirklich knapp (nicht nur Cache)
node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes < 0.10

# Steal Time: der Hypervisor nimmt Rechenzeit weg
rate(node_cpu_seconds_total{mode="steal"}[5m]) > 0.05

# Maschine neu gestartet, ohne dass jemand davon wusste
time() - node_boot_time_seconds < 600
predict_linear ist die nützlichste der vier: Sie meldet nicht „Platte zu 90 % voll“ (was manchmal jahrelang so bleibt), sondern „bei diesem Tempo ist sie morgen voll“.
Schicht 3: Der Alarmweg und wer ihn überwacht#
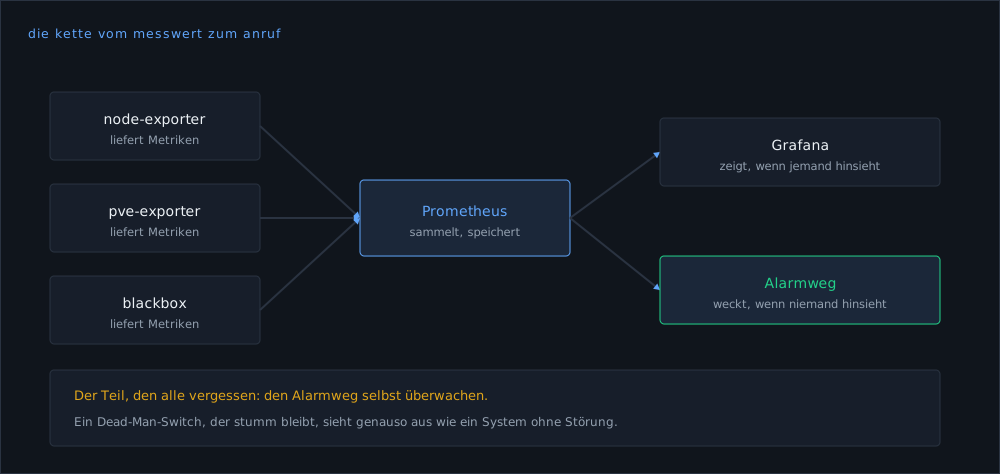
Grafana ist zum Hinsehen. Der Alarmweg ist zum Gewecktwerden. Beides zu verwechseln, ist der häufigste Fehler.
Ein Telegram-Bot ist für kleine Umgebungen ein pragmatischer Weg: keine Mail-Zustellbarkeit im Spiel, Push auf dem Telefon, kostenlos.
# Chat-ID herausfinden, nachdem man dem Bot einmal geschrieben hat
curl -s "https://api.telegram.org/bot<TOKEN>/getUpdates" | jq '.result[0].message.chat.id'

# Testnachricht
curl -s -X POST "https://api.telegram.org/bot<TOKEN>/sendMessage" \
-d chat_id=<CHAT_ID> -d text="Testalarm von web01"Ein Alarmweg, der stumm bleibt, sieht exakt aus wie ein System ohne Störung. Wir hatten genau diesen Fall: Ein Benachrichtigungsdienst nutzte eine eigene Namensauflösung und ignorierte einen Eintrag in /etc/hosts, der für den Rest des Systems korrekt war. Nichts war kaputt, es kam nur nie etwas an und das wochenlang unbemerkt.
Die Gegenmaßnahme ist ein Dead-Man-Switch: ein Alarm, der auslöst, wenn ein regelmäßiges Lebenszeichen ausbleibt.
Dead-Man-Switch einrichten#
In Uptime Kuma einen Monitor vom Typ Push anlegen. Kuma gibt eine URL aus und schlägt Alarm, wenn dort länger als das eingestellte Intervall nichts eintrifft.
Auf dem überwachten System per systemd-Timer alle fünf Minuten anpingen:
# /etc/systemd/system/heartbeat.service
[Unit]
Description=Lebenszeichen an Uptime Kuma

[Service]
Type=oneshot
ExecStart=/usr/bin/curl -fsS -m 10 --retry 2 https://status.example.com/api/push/AbCdEf?status=up
# /etc/systemd/system/heartbeat.timer
[Unit]
Description=Lebenszeichen alle 5 Minuten
[Timer]
OnBootSec=2min
OnUnitActiveSec=5min
[Install]
WantedBy=timers.targetsudo systemctl enable --now heartbeat.timerDenselben Mechanismus für den nächtlichen Backup-Lauf verwenden, mit Intervall 25 Stunden. Bleibt das Signal aus, ist entweder das Backup nicht gelaufen oder die Maschine weg. Beides will man wissen. Die passende ExecStartPost-Zeile steht in Backup-Strategie 3-2-1.
Und den Alarmweg testen#
Einmal im Quartal, bewusst:
# Heartbeat anhalten und warten, ob die Meldung kommt
sudo systemctl stop heartbeat.timer
# ... auf die Benachrichtigung warten ...
sudo systemctl start heartbeat.timer
Ein Alarmweg, der nie ausgelöst hat, ist ein Alarmweg mit unbekanntem Zustand.
Was nicht überwacht werden sollte#
Genauso wichtig wie die Liste oben: Alles, was zu einer Benachrichtigung führt, bei der man nichts tut, gehört abgeschaltet. Alarmmüdigkeit ist real, nach der dritten belanglosen Nachtmeldung wird auch die vierte weggewischt, und die war dann die echte.
Konkret nicht als Alarm, sondern höchstens als Diagramm:
- CPU-Auslastung über X % (ohne Dauer und Zusammenhang bedeutungslos)
- einzelne fehlgeschlagene Anmeldeversuche (das ist Grundrauschen, siehe SSH härten)
- kurze Antwortzeit-Spitzen ohne Fehler
Der Zustand, den man anstrebt#
- Ausfall eines Dienstes → Nachricht innerhalb von zwei Minuten, von einer anderen Maschine aus geprüft.
- Backup nicht gelaufen → Nachricht am nächsten Morgen.
- Platte in 48 Stunden voll → Nachricht, bevor es passiert.
- Monitoring selbst kaputt → Dead-Man-Switch meldet sich.
- Alles in Ordnung → keine Nachricht.
Punkt 5 ist der, der über die Haltbarkeit des ganzen Aufbaus entscheidet.
Geschrieben aus dem laufenden Betrieb: MRMedia betreibt eigene Proxmox- Hosts, einen Backup-Server und Kundendienste in der EU. Fehler in einer Anleitung sind Fehler im eigenen Betrieb. Korrekturen bitte über Discord.