Ein Proxmox-Cluster fasst mehrere Hosts zu einer Verwaltungseinheit zusammen: eine Oberfläche, gemeinsame Berechtigungen, Live-Migration zwischen Knoten. Das ist bequem. Was ein Cluster nicht automatisch mitbringt, ist Hochverfügbarkeit, dafür braucht es zusätzlich gemeinsamen Storage und eine funktionierende Fencing-Strategie.
Dieser Beitrag beschreibt den Aufbau und, ebenso wichtig, die Bedingungen, unter denen ein Cluster mehr Probleme schafft als löst.
Quorum: warum drei und nicht zwei#
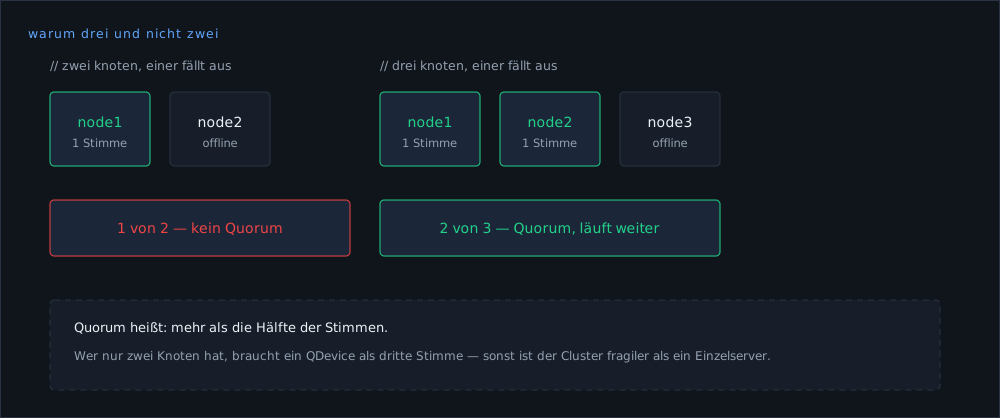
Corosync, die Cluster-Kommunikation unter Proxmox, arbeitet mit Stimmen. Handlungsfähig ist der Cluster nur mit mehr als der Hälfte aller Stimmen. Das verhindert Split-Brain: zwei Hälften, die sich nicht sehen und beide glauben, sie seien die richtige.
Die Konsequenz für zwei Knoten: Fällt einer aus, hat der andere eine von zwei Stimmen, keine Mehrheit. Der verbliebene Knoten setzt das Cluster-Dateisystem /etc/pve auf schreibgeschützt. Laufende Gäste laufen weiter, aber du kannst keine starten, keine ändern, keine Konfiguration schreiben.
Ein Zwei-Knoten-Cluster ist damit fragiler als zwei Einzelserver. Das ist der wichtigste Satz dieses Beitrags.
Voraussetzungen prüfen, bevor irgendetwas passiert#
# Auf jedem künftigen Knoten:
pveversion              # gleiche Hauptversion auf allen Knoten
hostname -f             # eindeutiger Name, muss auflösbar sein
chronyc tracking        # Uhren dürfen nicht auseinanderlaufen
Und die Latenz zwischen den Knoten, gemessen über einige Minuten:
ping -c 200 -i 0.2 node2.example | tail -2| Latenz zwischen den Knoten | Bewertung |
|---|---|
| unter 2 ms | unauffällig, gleicher Standort |
| 2-10 ms | funktioniert, Corosync-Timeouts im Blick behalten |
| 10-30 ms | machbar, aber jeder Netz-Schluckauf wird sichtbar |
| über 30 ms oder schwankend | kein Cluster bauen |
Corosync ist auf niedrige und vor allem gleichmäßige Latenz ausgelegt. Nicht der Mittelwert bringt einen Cluster ins Wanken, sondern die Ausreißer: Ein Knoten, der für 1,5 Sekunden nicht antwortet, gilt als tot und wird ausgeschlossen.
Ein Cluster über zwei Rechenzentren mit 15 ms Latenz läuft, bis das erste Routing-Ereignis dazwischenfunkt. Wenn das Ziel „eine Oberfläche für alle Hosts“ ist, ist eine gemeinsame Übersicht ohne Cluster (getrennte Hosts, ein zentrales Monitoring) oft die stabilere Lösung.
Cluster-Verkehr gehört in ein eigenes Netz#
Corosync soll nicht über dieselbe Leitung laufen wie Backups und Gastverkehr. Bei Servern an verschiedenen Standorten heißt das praktisch: ein Overlay-Netz, das die Knoten privat verbindet, WireGuard direkt, oder ein Mesh-Werkzeug darüber.
Minimalbeispiel mit WireGuard, ein Netz 10.99.0.0/24:
# /etc/wireguard/wg0.conf auf node1
[Interface]
Address = 10.99.0.1/24
ListenPort = 51820
PrivateKey = <privat-node1>

[Peer]
PublicKey = <oeffentlich-node2>
Endpoint = 198.51.100.20:51820
AllowedIPs = 10.99.0.2/32
PersistentKeepalive = 25
systemctl enable --now wg-quick@wg0
ping -c3 10.99.0.2Danach /etc/hosts auf allen Knoten so setzen, dass die Cluster-Namen auf die Overlay-Adressen zeigen:
10.99.0.1  node1.example node1
10.99.0.2  node2.example node2
10.99.0.3  node3.example node3
WireGuard verkleinert die nutzbare Paketgröße. Bleibt die MTU auf 1500, funktionieren kleine Pakete (Ping, Corosync-Heartbeat) einwandfrei, während größere Übertragungen, etwa eine Migration, kommentarlos hängen. ip link set wg0 mtu 1420 ist der übliche Startwert; ob er passt, zeigt ping -M do -s 1392 10.99.0.2.
Cluster anlegen#
Auf dem ersten Knoten:
pvecm create mrm-cluster --link0 10.99.0.1
pvecm status
Auf jedem weiteren Knoten, der Knoten muss leer sein, existierende Gäste gehen dabei verloren:
pvecm add 10.99.0.1 --link0 10.99.0.2Prüfen:
pvecm status          # Quorum, Anzahl Stimmen, Link-Zustand
pvecm nodes
corosync-cfgtool -s   # Zustand der Ringe
QDevice: die dritte Stimme ohne dritten Host#
Wenn nur zwei echte Knoten möglich sind, gibt ein QDevice die fehlende Stimme. Das kann ein winziger Rechner sein, ein Container irgendwo, ein Raspberry Pi, ein kleiner VPS. Er braucht keinen Storage und keine Rechenleistung, nur Erreichbarkeit.
Auf dem QDevice-Host (ein normales Debian):
apt install -y corosync-qnetd
systemctl enable --now corosync-qnetd
Auf beiden Cluster-Knoten:
apt install -y corosync-qdeviceDann auf einem Knoten:
pvecm qdevice setup 10.99.0.99
pvecm status        # muss jetzt 3 erwartete Stimmen zeigen
Wichtig: Das QDevice steht sinnvollerweise an einem dritten Ort. Ein QDevice im selben Rechenzentrum wie Knoten 1 löst genau die Ausfälle nicht, für die man es gebaut hat.
Hochverfügbarkeit, nur mit gemeinsamem Storage#
Ein Cluster verschiebt Gäste. Damit ein Gast nach dem Ausfall eines Knotens woanders starten kann, müssen seine Daten dort verfügbar sein. Ohne gemeinsamen Storage (Ceph, NFS, iSCSI) oder wenigstens ZFS-Replikation gibt es nichts zu starten.
Die kleine Variante ohne Shared Storage ist die ZFS-Replikation: Proxmox schickt in festen Abständen inkrementelle Snapshots zum Zielknoten.
# Alle 15 Minuten von node1 nach node2 replizieren
pvesr create-local-job 100-0 node2 --schedule "*/15" --rate 50
pvesr status
Das bedeutet im Ernstfall bis zu 15 Minuten Datenverlust. Das ist kein Makel, sondern eine bewusste Entscheidung, die man kennen und aufschreiben sollte.
Aktivierst du den HA-Manager, startet Proxmox Gäste eines als tot geltenden Knotens woanders neu. Läuft der „tote“ Knoten in Wirklichkeit weiter und hat nur die Netzverbindung verloren, existiert derselbe Gast zweimal, mit denselben Daten. Proxmox löst das über einen Selbst-Fence per Watchdog: Ein Knoten ohne Quorum startet sich nach kurzer Zeit selbst neu. Genau deshalb darf man den Watchdog nicht abschalten, „weil er einmal gestört hat“.
Wenn ein Knoten weg muss#
# Auf einem verbleibenden Knoten, nachdem der andere aus ist:
pvecm delnode node3
pvecm status
Der entfernte Knoten darf nie wieder in denselben Cluster gebootet werden, ohne vorher neu installiert worden zu sein, seine Reste in /etc/pve bringen den Cluster durcheinander.
Die Entscheidungshilfe#
| Ziel | Cluster nötig? |
|---|---|
| Eine Oberfläche für mehrere Hosts | ja, das ist der Kernnutzen |
| Live-Migration zwischen Hosts | ja, plus schnelles Netz zwischen ihnen |
| Automatischer Neustart nach Hostausfall | ja, plus Shared Storage und Fencing |
| Backups zentral verwalten | nein, dafür reicht ein PBS |
| Zwei Hosts an zwei Standorten mit 40 ms Latenz | nein, getrennt lassen |
Der häufigste Fall in kleinen Umgebungen ist Zeile 4: Man will eigentlich zentrale Backups und Übersicht, nicht Hochverfügbarkeit. Dafür braucht es keinen Cluster und man erspart sich Corosync-Timeouts in jeder unruhigen Nacht.
Geschrieben aus dem laufenden Betrieb: MRMedia betreibt eigene Proxmox- Hosts, einen Backup-Server und Kundendienste in der EU. Fehler in einer Anleitung sind Fehler im eigenen Betrieb. Korrekturen bitte über Discord.